

AMD展现Enterprise AI软件实力 实机展示企业级模型部署与GPU资源管理
- 张姝宁/台北
-

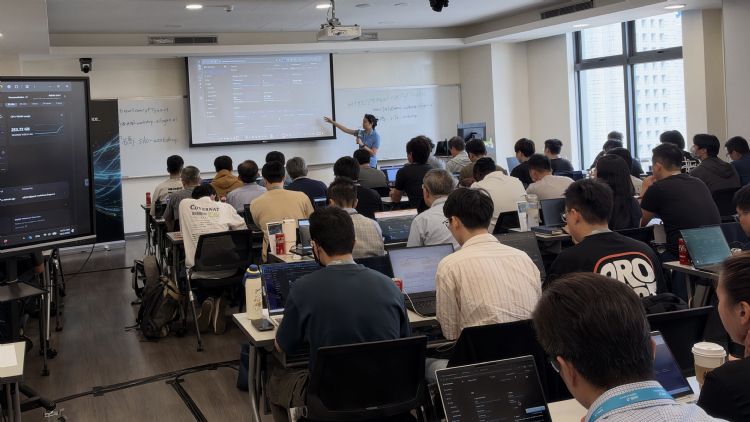
生成式AI加速进入企业应用,市场关注焦点也由GPU算力延伸至模型部署、资源管理与应用整合。企业取得运算资源后,如何将模型导入既有IT环境并转化为实际应用,成为AI落地的下一道课题。AMD近日在台举办首场Enterprise AI Workshop,透过实机操作展示模型部署、效能测试、模型微调、GPU资源管理及AI应用建置等流程,呈现其企业AI布局由GPU与基础软件向实际部署环境延伸。
模型推论、开发工具、Kubernetes工作负载调度、GPU资源配置与应用整合等需求,AMD透过Enterprise AI软件套件,提供涵盖模型推论、开发部署、工作负载管理与GPU资源管理的企业AI参考架构。其中,AMD Enterprise AI 软件套件涵盖AMD Solution Blueprints、AMD Inference Microservices(AIMs)、AMD AI Workbench及AMD Resource Manager,分别对应应用建置、模型推论、开发部署与GPU资源管理,串接模型、软件与底层运算资源。
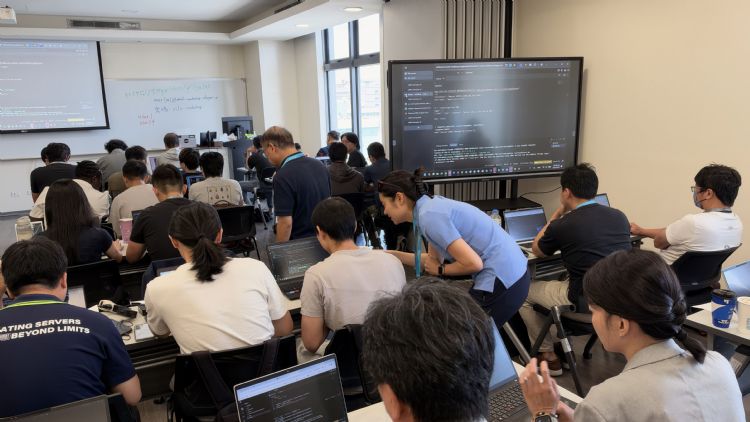
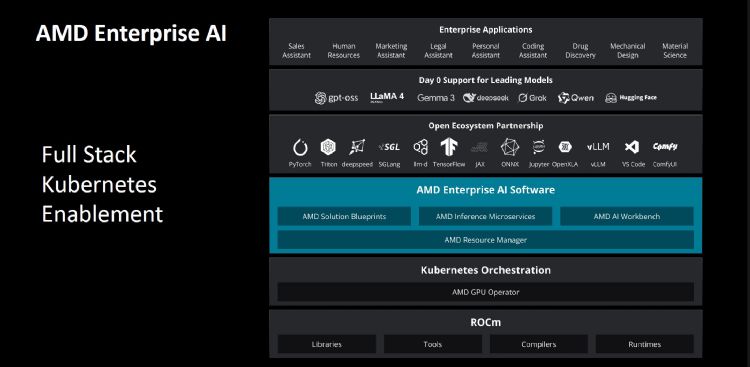
此次AMD Enterprise AI Workshop则将上述架构带入实际操作。参与者直接连线至AMD建置的环境,操作AIMs与AI Workbench部署及微调模型,并透过Kubernetes了解工作负载与GPU之间的调度机制,再利用Resource Manager管理专案与GPU资源,最后以Solution Blueprints展示如何将模型与推论服务组成实际AI应用。这套由模型部署、底层调度、资源管理到应用建置的流程,也成为此次Workshop的主要脉络。
企业AI部署复杂度升高 AMD扩充软件工具链
透过AI提升营运效率、加速产品与服务创新,已成为企业数码转型的重要策略。不过建置AI基础设施、取得GPU运算资源后,仍须处理模型部署、推论环境建置、使用者权限、GPU资源配置及工作负载监控等软件整合问题。企业近年积极采购GPU,但如何让不同团队有效使用运算资源,同时兼顾效能与管理需求,已成为实际部署时的重要课题。不同产业的需求也有所差异,例如金融业因重视数据安全与延迟,较倾向建置地端GPU丛集;电信业除了支持自身AI工作负载,也可能将自建GPU资源提供客户使用。
为协助企业降低自行整合软件堆叠的复杂度,AMD Enterprise AI软件套件 涵盖应用建置、模型推论、开发部署及GPU资源管理等环节。其四项主要元件包括AMD Solution Blueprints、AMD推论微服务(AMD Inference Microservices;AIMs)、AMD AI Workbench及AMD Resource Manager。相关软件以开源方式为主要方向;在实际导入与验证阶段,企业亦可视专案需求,与AMD技术团队及合作夥伴进行技术评估与部署验证。
对已建置AI环境的使用者而言,评估GPU平台牵涉的不只是硬件效能与采购成本,既有模型能否持续使用、Kubernetes环境如何衔接,以及资源管理与开发流程需要多少调整,都会影响实际导入成本。因应这类需求,AMD近年持续强化ROCm的效能与软件生态,并透过AMD Enterprise AI 软件套件将软件布局延伸至模型推论、开发部署、GPU资源管理与应用建置,让既有AI工作流程更容易延续至AMD运算平台,减少部署、调校及软件转换所需的工作。
AIMs封装推论服务 AMD AI Workbench降低部署与微调门槛
模型进入实际部署阶段后,企业通常需要自行准备ROCm、vLLM等推论环境,取得模型并建立服务端点,再依硬件与工作负载进行效能调校。AMD推论微服务(AIMs)采容器形式,预先整合模型与推论所需的软件环境,降低部署过程中的设定工作。目前AIMs目录涵盖DeepSeek、GLM、MiniMax、GPT-OSS等模型,企业可依应用需求选择部署。实际可用模型与版本仍以当时发布的产品目录为准。
AMD AI Workbench则提供图形化操作界面,让使用者选择AIMs并完成部署,不必直接操作底层Kubernetes指令。此次Workshop实机操作中,参与者可依应用需求选择优先降低首Token延迟(Time to First Token),或提高整体推论吞吐量,也能调整vLLM相关参数。模型启动后,Workbench可显示首Token延迟、Token间延迟及端到端延迟等指标,并呈现GPU存储器、CPU Core与系统存储器使用状况,作为效能测试与部署调整的依据。
AMD AI Workbench也将模型微调纳入图形化流程。使用者可上传自有数据集、选择基础模型及设定相关参数,再以LoRA方式进行微调;完成后,可将原始模型与微调后模型并列,以相同问题比较输出结果,检视微调效果。相较自行透过命令列搭配Python、PyTorch等工具建立微调流程,图形化操作可减少环境设定与操作步骤。
图形化界面之外,AIMs仍可与既有开发流程串接。模型部署完成后,开发者可取得服务端点,透过Python程序呼叫模型;Workshop也示范利用VS Code连接已部署的AIMs,执行模型呼叫与效能测试。企业若已有自己的应用系统,也可透过服务端点连接AIMs,将模型推论能力纳入既有服务。
Kubernetes负责底层调度 串接AI工作负载与GPU资源
AMD AI Workbench与AIMs简化了使用者看到的模型部署流程,底层的工作负载调度则由Kubernetes负责。企业AI环境中的数据准备、模型训练、推论及监控,都可透过Kubernetes管理,并处理GPU资源配置、安全隔离、版本更新等工作。对已经使用Kubernetes建置IT环境的企业而言,也可延续既有的容器与资源管理方式部署AI工作负载。
以AIMs部署为例,使用者透过Workbench提出部署需求后,系统会建立对应的Pod,由Pod提出GPU资源需求;AMD Device Plugin则负责识别各节点可用的GPU资源,让Kubernetes排程器选择具备足够资源的节点,再由kubelet启动包含AIMs的容器并持续回报执行状态。当容器失效、Pod数量不足或设定变更时,Kubernetes也会依照预先宣告的目标状态进行调整,维持工作负载正常运作。
图形化界面之外,熟悉Kubernetes的开发者仍可透过命令列操作。Workshop现场也示范以YAML定义部署内容,再透过kubectl建立及管理工作负载;企业可依需求采用Kubernetes Deployment、KServe或Docker等方式部署,保留较大的定制与底层控制空间。当多个团队与工作负载共享同一套GPU基础设施时,Kubernetes则可透过命名空间(namespace)区隔不同专案,维持资源与权限隔离。
不过,当GPU丛集规模扩大,管理需求也会由单一工作负载的部署与调度,延伸至整体资源的配置与使用状况。如何设定各专案可使用的GPU数量、掌握资源占用情形及调整配额,也成为管理者需要处理的问题。
AMD Resource Manager集中管理GPU 掌握专案配额与使用状况
AMD Resource Manager提供图形化管理界面,将GPU管理范围由单一工作负载延伸至专案与整体丛集。透过仪表板,可依丛集、节点、专案及工作负载查看GPU使用状况,包括使用率、存储器、温度、功耗及PCIe流量等信息。这些数据来自AMD GPU Operator与GPU Driver,并将原本透过AMD SMI或ROCm SMI取得的信息整合至同一界面,方便集中掌握GPU运作状态。
除了监控GPU使用情形,Resource Manager也能以专案为单位分配运算资源,包括设定GPU、CPU Core、存储器及存储空间配额,以及管理成员与存取权限。模型部署所需的Hugging Face Token、S3存储凭证等信息,也可依专案统一管理,让不同团队共享GPU基础设施时,仍能维持各自的资源配置与权限隔离。
面对规模更大的部署环境,Resource Manager可支持连接多个丛集,让管理者透过同一界面掌握不同丛集的资源状态。AMD指出,由于多丛集部署涉及网络及基础设施设定,正式导入前仍须完成相关测试与验证,再依实际环境规划管理方式。
AMD Solution Blueprints整合模型与服务 加速AI应用落地
完成模型部署与GPU资源配置后,下一步是结合模型与企业需求,形成可实际使用的AI应用。AMD Solution Blueprints提供预先整合的参考应用,将模型、推论服务及应用程序所需元件组合在一起。目前已有二十多种应用范例,涵盖医疗、金融服务与电信等垂直市场,包括医疗影像分析、代理式RAG、代理式翻译、文件摘要、金融诈欺侦测及电信助理等。
AMD Enterprise AI Workshop现场以MRI影像分析Blueprint示范实际部署。开发者可透过Helm Chart将Blueprint部署至Kubernetes,建立应用所需的服务、Pod及AIMs,并依需求调整模型、数据库及存储环境。此次示范采用GPT-OSS 20B AIMs作为推论服务,企业也可替换其他模型,或直接呼叫已部署的AIMs,依自身应用需求调整整体架构。
此设计也让不同应用可以共享既有的AIMs服务,不必为每套应用重复部署模型,减少GPU、CPU与存储器资源的重复占用。开发团队则可将更多工作集中在应用流程与企业数据整合,降低重复建置底层推论环境的工作。因此 AMD Solution Blueprints也成为AMD Enterprise AI 软件套件中接近应用端的一环,将前述模型部署、GPU调度与资源管理能力延伸至实际AI应用。
后续产品规划方面,AMD将持续扩大Enterprise AI软件套件的硬件与模型支持范围,包括加入AMD Instinct MI350P,并规划延伸至Ryzen平台;AIMs模型目录也将持续扩充,除了通用大型语言模型,也将增加生命科学相关模型,涵盖蛋白质折叠、药物研发等工作负载,扩大不同运算平台与产业应用的支持范围。
欲了解更多信息欢迎参阅AMD Enterprise AI Reference Stack与AMD Enterprise AI Documentation。